Corrigé banque PT 2026 : mathématiques A
Aller à un exercice ou une partie
un corrigé annales-concours.fr
Proposition de corrigé — non officielle. Banque PT, session 2026, mathématiques A, épreuve de quatre heures sans calculatrice. Les quatre parties sont traitées, avec graphique et programme Python.
Télécharger ce corrigé en PDF · Ouvrir le sujet officiel · Télécharger une copie du sujet · Retrouver les annales
Partie A — Matrices M(a, b)
On écrit M(a, b) sous la forme de deux lignes (a, b) et (1, 1). Son polynôme caractéristique est χ(λ) = λ² − (a + 1)λ + a − b.
A1. Critère de trigonalisation
Une matrice est trigonalisable sur un corps K si et seulement si son polynôme caractéristique est scindé sur K. En particulier, toute matrice complexe est trigonalisable sur C ; sur R, ses valeurs propres doivent être réelles.
A2. Matrice M₁
Pour a = 2 et b = 6, χ(λ) = λ² − 3λ − 4 = (λ − 4)(λ + 1). Les deux valeurs propres réelles sont distinctes : M₁ est diagonalisable sur R et sur C.
On peut prendre P₁ = [(3, −2) ; (1, 1)], dont les colonnes sont les vecteurs propres (3, 1) et (−2, 1), et D₁ = diag(4, −1). Le déterminant de P₁ vaut 5, donc P₁ est inversible, et M₁ = P₁D₁P₁⁻¹. La notation entre crochets sépare ici les lignes par un point-virgule.
A3. Matrice M₂
Pour a = 3 et b = −2, χ(λ) = λ² − 4λ + 5, de racines 2 + i et 2 − i. M₂ est diagonalisable sur C, mais pas sur R.
Avec les vecteurs propres (1 + i, 1) et (1 − i, 1), on obtient P₂ = [(1 + i, 1 − i) ; (1, 1)] et D₂ = diag(2 + i, 2 − i). Le déterminant de P₂ vaut 2i ≠ 0.
A4. Matrice M₃
Son polynôme est (λ − 3)². M₃ n’est pas égale à 3I : elle ne peut donc pas être diagonalisable avec pour seule valeur propre 3. Elle est en revanche trigonalisable sur R.
Posons v₁ = (2, 1) et v₂ = (1, 0). On vérifie f₃(v₁) = 3v₁ et f₃(v₂) = v₁ + 3v₂. Le déterminant des deux vecteurs vaut −1. Dans la base (v₁, v₂), la matrice est donc bien T₃ = [(3, 1) ; (0, 3)].
A5 à A7. Inversibilité et diagonalisation
A5. Le déterminant vaut a − b. La condition nécessaire et suffisante d’inversibilité est a ≠ b.
A6. Le discriminant est Δ(a, b) = (a − 1)² + 4b.
A7a. Si Δ = 0, la seule valeur propre est (a + 1)/2. Une matrice diagonalisable avec une seule valeur propre devrait être scalaire, ce que la présence du coefficient 1 en position (2, 1) interdit. Elle n’est donc pas diagonalisable, même sur C.
A7b. Si Δ > 0, les valeurs propres réelles sont distinctes : diagonalisation sur R et C. Si Δ < 0, elles sont complexes non réelles et distinctes : diagonalisation sur C uniquement.
A8. Représentation dans le plan (a, b)
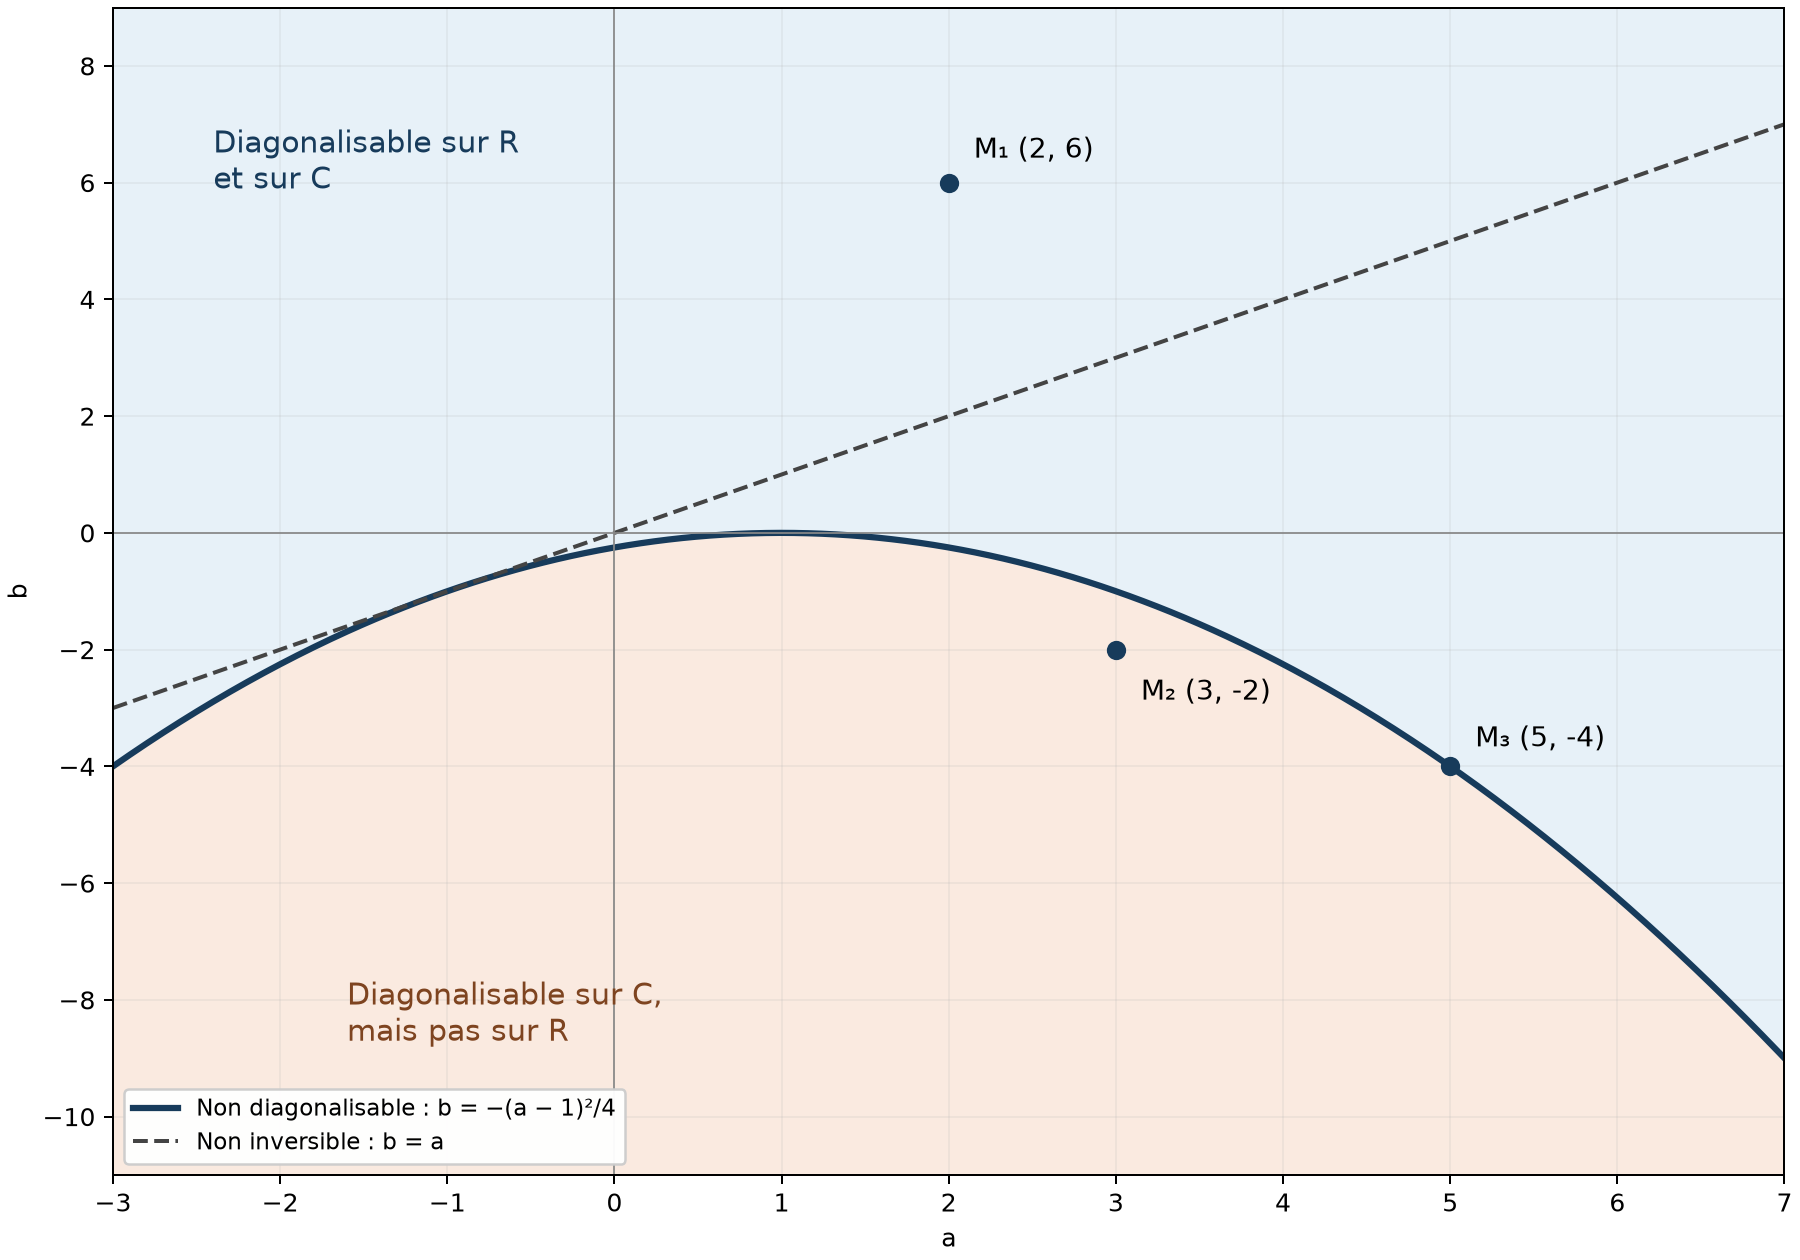
La non-inversibilité correspond à la droite b = a. La frontière des régions de diagonalisation est la parabole b = −(a − 1)²/4, de sommet (1, 0) : au-dessus, diagonalisation réelle ; au-dessous, diagonalisation complexe uniquement ; sur la parabole, aucune diagonalisation. La droite de non-inversibilité reste au-dessus de la parabole et lui est tangente en (−1, −1) : sur b = a, le discriminant vaut (a + 1)². Toutes les matrices de cette droite, sauf au point de tangence, sont donc diagonalisables sur R tout en étant non inversibles. La droite ne pénètre jamais dans la région de diagonalisation complexe uniquement.
Les trois points sont M₁ : (2, 6), M₂ : (3, −2) et M₃ : (5, −4).
Partie B — Loi conjointe de X et Y
Les valeurs sont −1, 0 et 1. La matrice de la loi conjointe est (1/12)[(1, 1, 2) ; (2, 2, 1) ; (1, 1, 1)]. U est la colonne (1, 1, 1) et V la colonne (−1, 0, 1).
B1. Loi et espérance de X
La iᵉ composante de CU additionne les probabilités de la ligne i, c’est-à-dire ΣⱼP(X = xᵢ, Y = xⱼ) = P(X = xᵢ). Ainsi :
| Valeur | P(X = valeur) | P(Y = valeur) |
|---|---|---|
| −1 | 4/12 = 1/3 | 4/12 = 1/3 |
| 0 | 5/12 | 4/12 = 1/3 |
| 1 | 3/12 = 1/4 | 4/12 = 1/3 |
Multiplier à gauche par Vᵀ pondère les probabilités par les valeurs de X : E(X) = VᵀCU = −1/3 + 1/4 = −1/12.
B2. Loi et espérance de Y
La loi de Y est donnée par CᵀU et son espérance par VᵀCᵀU. Le tableau montre que Y est uniforme sur les trois valeurs, donc E(Y) = 0.
B3 et B4. Produit et covariance
VᵀCV = ΣᵢΣⱼ xᵢxⱼcᵢⱼ représente E(XY). Seuls les quatre coins contribuent : E(XY) = (1 − 2 − 1 + 1)/12 = −1/12.
La covariance est donc Cov(X, Y) = E(XY) − E(X)E(Y) = −1/12.
B5. Indépendance
X et Y ne sont pas indépendantes. Première justification : leur covariance est non nulle, alors que l’indépendance imposerait une covariance nulle. La réciproque de ce critère n’est pas générale.
Deuxième justification : P(X = 0, Y = 0) = 2/12 = 1/6, tandis que P(X = 0)P(Y = 0) = (5/12)(1/3) = 5/36. Ces deux probabilités sont différentes.
B6. Trace
Les cases diagonales correspondent aux événements X = Y. Ainsi tr(C) = P(X = Y) = (1 + 2 + 1)/12 = 1/3.
Partie C — Matrice aléatoire
C1. Lorsque A = X et B = Y
a. La matrice est inversible lorsque A ≠ B. La réponse B6 donne donc P(inversible) = 1 − 1/3 = 2/3.
b. L’absence de diagonalisation même complexe correspond à Δ(A, B) = 0. Parmi les neuf couples possibles, ce sont (−1, −1) et (1, 0). Leur probabilité totale vaut 1/12 + 1/12 = 1/6.
C2. Égalité de deux variables indépendantes
L’événement A = B est la réunion disjointe des événements {A = k, B = k}. En utilisant l’indépendance :
P(A = B) = Σₖ∈H P(A = k)P(B = k).
On peut sommer sur un ensemble commun contenant leurs valeurs ; une valeur impossible pour l’une des variables contribue zéro.
C3. Loi binomiale et loi géométrique
a. Pour A de loi B(n, p), les valeurs possibles sont 0 à n, avec P(A = k) = C(n, k)pᵏ(1 − p)^(n−k).
b. Avec la convention du sujet pour la loi géométrique, B prend les valeurs 1, 2, …, et P(B = k) = r(1 − r)^(k−1).
c. La non-inversibilité équivaut à A = B. En sommant de k = 1 à n et en factorisant r/(1 − r), on obtient :
P(A = B) = [r/(1 − r)] Σₖ₌₁ⁿ C(n, k)[p(1 − r)]ᵏ(1 − p)^(n−k).
La formule du binôme, après retrait du terme k = 0, donne P(non inversible) = [r/(1 − r)][(1 − pr)ⁿ − (1 − p)ⁿ].
C4. A et C = −B de lois de Poisson
a. A prend les valeurs de N, avec P(A = k) = e^(−λ)λᵏ/k!.
b. C reste indépendante de A, puisque c’est une fonction de B. Les fonctions génératrices sont G_A(s) = e^[λ(s−1)] et G_C(s) = e^[µ(s−1)]. Leur produit est e^[(λ+µ)(s−1)] : A + C suit donc la loi de Poisson de paramètre λ + µ.
c. Ici A ≥ 0 et B = −C ≤ 0. A = B ne peut se produire que pour A = C = 0, donc pour A + C = 0. La probabilité de non-inversibilité vaut e^(−λ−µ), et P(inversible) = 1 − e^(−λ−µ).
C5. Deux lois de Poisson positives
On revient à A de paramètre λ et B de paramètre µ, indépendantes et toutes deux à valeurs positives ou nulles. La formule de C2 donne :
I = P(A = B) = e^(−λ−µ) Σₖ₌₀^∞ (λµ)ᵏ/(k!)².
C6. Approximation par somme partielle
a. Pour k ≥ n + 1, on a k! ≥ (n + 1)!, donc 1/(k!)² ≤ 1/[(n + 1)! k!]. Tous les termes étant positifs :
0 ≤ Rₙ ≤ [e^(−λ−µ)/(n + 1)!] Σₖ₌ₙ₊₁^∞ (λµ)ᵏ/k! ≤ e^(λµ−λ−µ)/(n + 1)!.
Le majorant demandé est établi ; il tend vers zéro, ce qui assure l’arrêt du calcul pour tout eps > 0, dans le modèle de calcul exact.
b. Voici une fonction utilisant le majorant pour choisir le rang de troncature :
from math import exp, factorial

def val_app(eps):
    n = 0
    x = la * mu
    scale = exp(-la - mu)
    total = scale
    bound_scale = exp(x - la - mu)
    while bound_scale / factorial(n + 1) > eps:
        n += 1
        total += scale * x**n / factorial(n)**2
    return total
À l’arrêt, l’erreur de troncature est au plus eps. Cette écriture répond à l’exercice ; pour de très grands paramètres, les débordements et erreurs d’arrondi exigeraient une autre implémentation numérique.
c. L’instruction à ajouter est print(val_app(1e-5)).
C7. Approximation par simulation
a. Jᵢ suit une loi de Bernoulli de paramètre I.
b. Les simulations étant indépendantes, K_N = ΣJᵢ suit la loi binomiale B(N, I).
c. Pour la fréquence K̄_N = K_N/N, E(K̄_N) = I et Var(K̄_N) = I(1 − I)/N.
d. Bienaymé–Tchebychev donne P(|K̄_N − I| ≥ ε) ≤ I(1 − I)/(Nε²). Comme I(1 − I) ≤ 1/4 : la probabilité est au plus 1/(4Nε²).
e. Par complémentarité, la probabilité que I appartienne à l’intervalle aléatoire [K̄_N − ε ; K̄_N + ε] est au moins 1 − 1/(4Nε²). Les bornes fermées peuvent seulement augmenter la probabilité par rapport à l’événement avec inégalité stricte.
f. La fréquence observée est 21 357/100 000 = 0,21357. Pour ε = 0,01, l’intervalle observé est [0,20357 ; 0,22357], et la garantie théorique de couverture est au moins 0,975, soit 97,5 %. C’est une garantie sur la procédure de construction de l’intervalle, non une probabilité attribuée a posteriori au paramètre fixe I.
Pour ε = 0,001, l’intervalle est [0,21257 ; 0,21457], mais le minorant devient 1 − 2,5 = −1,5. Il est trivial : l’inégalité ne fournit ici aucune garantie positive utile. Elle ne démontre ni que cet intervalle est faux, ni que sa probabilité de couverture est négative.
Partie D — Rang d’une loi conjointe
Notons p et q les colonnes des probabilités marginales de X et Y. Toutes leurs composantes sont positives ou nulles et chacune somme à 1.
D1a. Rang sous indépendance
L’indépendance donne Q = pqᵀ. Les deux vecteurs sont non nuls ; toutes les colonnes sont des multiples de p et au moins l’une est non nulle. Le rang est 1.
D1b. Valeurs propres et multiplicités
Posons τ = qᵀp. Le vecteur p est propre pour τ, car Qp = p(qᵀp). Tout vecteur du noyau de qᵀ, espace de dimension n − 1, est annulé par Q. Avec l’hypothèse pᵢ > 0 pour tout i, on a τ > 0 puisque certains qᵢ sont positifs. Les valeurs propres sont donc τ, de multiplicité 1, et 0, de multiplicité n − 1, lorsque n > 1. Pour n = 1, seule τ = 1 apparaît.
D1c. Diagonalisation
Les sous-espaces Vect(p) et ker(qᵀ) sont en somme directe : p n’appartient pas au noyau car qᵀp = τ > 0. Leurs dimensions totalisent n. Une base de chacun forme donc une base de vecteurs propres : Q est diagonalisable sur R. On retrouve aussi l’identité Q² = τQ.
D1d. Contre-exemple sans positivité de toutes les masses de X
Prenons, sur les listes de quatre valeurs distinctes proposées, p = (1/2, 1/2, 0, 0) et q = (0, 0, 1/2, 1/2). X et Y sont indépendantes et non constantes : chacune prend effectivement deux valeurs. Leur matrice est :
Q = [(0, 0, 1/4, 1/4) ; (0, 0, 1/4, 1/4) ; (0, 0, 0, 0) ; (0, 0, 0, 0)].
Ici qᵀp = 0 : Q² = 0, mais Q ≠ 0. Une matrice nilpotente diagonalisable serait nulle, donc Q ne l’est pas. On interprète les listes x₁, …, x₄ et y₁, …, y₄ comme des listes autorisant des probabilités nulles, ce que demande précisément la suppression de l’hypothèse. Si l’écriture X(Ω) est prise au sens strict d’un support discret de masses toutes positives, cette demande de l’énoncé est incohérente.
D2. Réciproque : rang 1 implique indépendance
Toute matrice Q de rang 1 s’écrit uvᵀ. La somme de ses coefficients vaut 1, donc (Σuᵢ)(Σvⱼ) = 1. Les marginales vérifient pᵢ = uᵢΣvⱼ et qⱼ = vⱼΣuᵢ. En multipliant :
pᵢqⱼ = uᵢvⱼ(Σuᵢ)(Σvⱼ) = uᵢvⱼ = qᵢⱼ.
Ainsi chaque probabilité conjointe est le produit des probabilités marginales : X et Y sont indépendantes. La preuve ne nécessite pas que toutes les masses marginales soient strictement positives.